Referenzprojekt · Eigenentwicklung
Agentic AI Engineering: ein KI-Assistent, entwickelt und geprüft mit KI
hentschel.ai ist ein KI-Anlageassistent, der Depot, Marktdaten und Anlageprofil zu nachvollziehbaren Analysen verbindet. Entstanden ist er in einem agentischen Entwicklungsprozess: KI-Coding-Agenten setzen um, mehrstufige Testautomatisierung und LLM-Evals sichern die Qualität, Guardrails mit Human-in-the-Loop-Freigaben die Governance. Die Methoden sind auf Enterprise-Vorhaben übertragbar – vom Pilot bis in den Betrieb.
Kunde
Hentschel Consulting GmbH – Eigenprodukt hentschel.ai

Projektart
Aufbau eines KI-Produkts von der Idee bis zum Betrieb – mit agentischem Entwicklungsprozess (AI-native SDLC), mehrstufiger Testautomatisierung und automatisierten LLM-Evals (Chat Grading)
Projektlaufzeit
05/2026 – laufend
Branche
Finanzdienstleistungen / FinTech – Methoden branchenübergreifend übertragbar
Projektsprache
Deutsch & Englisch
Länder
Global
Rolle
Produktverantwortung, Lösungsarchitektur, KI-Qualitätssicherung (LLM-Evals) und Umsetzung mit KI-Coding-Agenten
Umfang & Komplexität
Vollständiger Produktlebenszyklus in Eigenverantwortung: von der Idee über Architektur und Entwicklung bis zur vollständig umgesetzten Anwendung mit Abo- und Zahlungsabwicklung. Die Plattform führt das Depot des Nutzers samt Transaktionen, Cash-Konten und Watchlist, reichert es mit Live-Kursen, Fundamental-, Technik- und Nachrichtendaten an und stellt einen KI-Assistenten daneben, der 55 spezialisierte Werkzeuge bedient – von Chart- und Bilanzanalyse über ETF-Durchsicht und Anleihen-Kennzahlen bis zu Sektor-, Regionen-, Währungs- und Themenauswertungen des Depots.
Die Analysebasis entsteht nicht im Dialog, sondern vorgelagert: 26 zeitgesteuerte Jobs bewerten ein Universum von rund 2'000 Titeln aus STOXX Europe 600, S&P 500, Nikkei 225 und MSCI Emerging Markets, aktualisieren Wechselkurse, klassifizieren Anlagethemen, protokollieren Marktkatalysatoren und schreiben Ergebnis-Momentaufnahmen fort. Der Assistent liest diese Ergebnisse, er erfindet sie nicht – jede Zahl in einer Antwort stammt aus einem Werkzeugaufruf. Dazu kommt die volle Breite eines Produkts: Registrierung mit Passwort und Passkeys, Abonnements und Guthabenpakete in drei Währungen, monatliche Verbrauchsmessung, Benachrichtigungen, E-Mail-Strecken, Datenschutz-, Impressums- und AGB-Fassungen sowie eine zweisprachige Oberfläche mit rund 5'900 Texten je Sprache.
Die eigentliche Komplexität liegt in der Disziplin: Ein Sprachmodell arbeitet probabilistisch, muss hier aber faktentreu und reproduzierbar sein – gleiche Frage, gleiche Zahlen. Sein Trainingswissen veraltet, während Kurse sich stündlich ändern. Beides ist nur lösbar, wenn das Modell keine Fakten aus sich selbst beisteuert, sondern ausschliesslich aus Werkzeugaufrufen und der vorgelagerten Bewertung liest. Wie das in Entwicklung, Test und Betrieb sichergestellt wird, zeigen die Abschnitte unten.
Konzeption & Methodik
Produkt vor Technik. Ausgangspunkt war eine konkrete Lücke: Allgemeine KI-Assistenten beraten eloquent, kennen aber weder das Depot des Nutzers noch belastbare Marktdaten; Robo-Advisor rechnen sauber, erklären aber nichts.
Messen, bevor gebaut wird (Evidence-based Engineering). Jede Analyse-Hypothese wird zuerst in einem separaten Auswertungsrahmen gegen historische Daten geprüft. Was nicht standhält, kommt nicht ins Produkt – das hat mehrfach Funktionen verhindert, die intuitiv überzeugend wirkten.
Nachvollziehbarkeit als Architekturprinzip (Traceability). Die Bewertung läuft deterministisch und zeitpunktgenau archiviert – gleicher Eingabestand, gleiches Ergebnis. Der KI-Anteil interpretiert und erklärt, er bewertet nicht selbst.
Datenschutz mit Standortwahl (Privacy by Design). KI-Aufrufe sind im Code auf die EU-Region eines Cloud-Anbieters festgelegt, ohne Speicherung der Anfragen und ohne Modelltraining. Einzige offengelegte Ausnahme ist die abschaltbare Web-Recherche.
Entwicklung mit KI-Agenten (Agentic Software Delivery). KI-Coding-Agenten setzen um, automatische Checks, eine versionierte Wissensbasis und klare Freigaben halten Tempo und Qualität zusammen.
Qualitätssicherung mit Automaten statt Meinungen (Evaluation-driven Development). Mehrstufige Testautomatisierung und automatisierte LLM-Evals: Prompt-, Werkzeug- und Modelländerungen werden gegen den Szenariokatalog gemessen.
Betrieb und Kostenkontrolle (LLMOps und FinOps). Verbrauch wird pro Nutzer und Monat gemessen und begrenzt, Modellkosten werden je Lauf gegen den tatsächlichen Kontostand geprüft.
Was das Projekt zeigt
"KI-Coding-Agenten verändern die Ökonomie von Enterprise-Projekten: Drastisch kleinere Teams mit weniger Spezialisten setzen komplexe Vorhaben schneller um. Zugleich erweitern KI-Modelle die Projekte um neue Funktionen im Umgang mit unstrukturierten Daten: Sie verstehen und erzeugen Inhalte in nahezu jedem digitalen Format. Der Engpass verschiebt sich von der Kapazität zur Kontrolle – erst automatisierte Prüfungen und klare Freigaben bringen KI sicher vom Pilot in den Betrieb."
Rainer Hentschel
Transformation Lead for the Autonomous Enterprise · SAP® Solutions & Agentic AI
Sieben Muster für Enterprise-AI
Muster A: Skalierbarer Entwicklungsprozess mit KI-Coding-Agenten
Agentic Software Delivery
- Agentic AI
- AI-native SDLC
- Human-in-the-Loop
- Least Privilege
- Model Context Protocol (MCP)
- Knowledge Management
Herausforderung: KI-Coding-Agenten liefern Code schneller, als Teams ihn klassisch prüfen können. Skalierbar wird das erst mit klaren Rollen, automatischen Checks und einem Projektgedächtnis, das nicht in Chat-Verläufen verloren geht.
-
Rollen (Human-in-the-Loop).
- Der Product Owner formuliert Anforderungen und Befunde.
- KI-Coding-Agenten setzen um, in der Entwicklungsumgebung und als Cloud-Agenten, die eigenständig Pull Requests erstellen.
- Über 150 Pull Requests wurden gemergt, fast alle von Cloud-Agenten erstellt.
-
Automatische Checks statt Vertrauen. Jeder Pull Request durchläuft automatisch:
- Formatierung, Typprüfung und rund 2'300 Unit-Tests (ca. 2 Minuten),
- die eingeloggte End-to-End-Suite gegen eine Wegwerf-Datenbank und ein deterministisches Testmodell (ca. 12 Minuten),
- einen Vorschau-Build.
-
Projektgedächtnis als Code (Knowledge Management für Agenten).
- Konventionen, Messergebnisse und Fehlerursachen liegen als versionierte Wissensbasis im Repository: 38 Dateien, rund 29'000 Zeilen.
- Jeder Agent startet mit demselben Wissen, jede Änderung daran ist ein prüfbarer Diff.
- Wissen gelangt nur über geprüfte Commits ins Repository.
-
Minimale Rechte (Least Privilege).
- Agenten haben keinen Schreibzugriff auf Produktionsdaten und nur die Zugangsdaten, die ihre Aufgabe braucht.
- Inhalte aus Tickets, Pull Requests und Fehlermeldungen gelten als nicht vertrauenswürdig (Prompt Injection).
Mehr Details
-
Sichere Testumgebungen.
- Vorschau-Umgebungen arbeiten nur mit anonymisierten Daten. Scheitert die Anonymisierung, scheitert der Build.
- Datenbankmigrationen laufen zuerst in Agenten- und Vorschau-Umgebungen ohne Verbindung zur Produktion – erst danach wird die Produktionsdatenbank angepasst.
-
Agenten-Umgebung als Code. Eine versionierte Einrichtung stellt den Coding-Agenten Werkzeuge, Wegwerf-Datenbank und Browser bereit; die Fehlerüberwachung ist lesend über das Model Context Protocol (MCP) angebunden.
-
Taktung. Über 1'700 Commits, in der Spitze 26 gemergte Pull Requests an einem Tag.
Beratungsmehrwert
- Operating Model für KI-gestützte Softwareentwicklung: Rollenmodell, Definition of Done für Agenten-Pull-Requests, Pflicht-Checks, Wissensbasis.
- Security Assessment agentischer Pipelines: Rechte, Zugangsdaten, Injection-Pfade.
- Skalierung vom Pilotteam auf Programmebene.
Muster B: Testautomatisierung für probabilistische Systeme
AI Quality Engineering
- Test Automation
- Shift-Left Testing
- Compliance as Code
- Mock-LLM
- Regression Testing
- CI/CD
Herausforderung: Klassische Tests erwarten exakte Ausgaben, ein Sprachmodell antwortet auf dieselbe Frage jedes Mal etwas anders. Qualität entsteht deshalb über mehrere Ebenen: deterministisch, wo es geht, statistisch, wo es muss.
-
Richtlinien als Tests (Compliance as Code, Shift-Left). Tests prüfen den gesamten Code auf feste Regeln – Verstösse fallen vor dem Merge auf, nicht im Betrieb:
- Jeder KI-Aufruf ist auf EU-Region, Zero Data Retention und Ausschluss von Modelltraining festgelegt; einzige offengelegte Ausnahme ist die abschaltbare Web-Recherche.
- Jeder zeitgesteuerte Job wird überwacht.
- Beide Sprachfassungen sind vollständig.
- Keine Werkzeugbeschreibung widerspricht einer definierten Prozesskette.
-
Unit-Tests. Rund 2'300 Testfälle in 218 Testdateien, vor allem für die rechnenden Werkzeuge.
-
End-to-End im Browser. 21 Playwright-Testdateien. Die eingeloggte Suite läuft in der CI gegen Wegwerf-Datenbank, Redis und ein deterministisches Mock-Modell: reproduzierbar und ohne Modellkosten.
-
Visuelle Prüfung. Automatisierte Screenshots aller Oberflächen in beiden Sprachen, hell und dunkel.
Mehr Details
-
Regression mit echtem Modell. Rund 120 bewertete Dialog-Szenarien mit Personas und eingefrorenen Marktdaten, damit Läufe über Wochen vergleichbar bleiben.
-
Experimente. Gepaarte A/B-Läufe mit Kontrolle der Eigenstreuung.
Beratungsmehrwert
- Teststrategie für KI-Anwendungen (AI Quality Engineering): welche Ebene was prüft, wo deterministisch und wo statistisch.
- Reproduzierbare Testumgebungen für LLM-Systeme: Mock-Modelle, eingefrorene Daten, Wegwerf-Infrastruktur.
- Unternehmensrichtlinien (Datenresidenz, Datenschutz, Monitoring) als automatisierte Tests.
Muster C: Chat Grading: Dialogqualität messbar machen
LLM Evals
- LLM-as-a-Judge
- Golden Set
- Grounding Checks
- Sycophancy-Tests
- Judge-Kalibrierung
- Rubric-based Scoring
Herausforderung: Ob eine KI-Antwort gut ist, entscheidet kein einzelner Assert. Ohne belastbare Bewertung bleibt jede Prompt-, Werkzeug- oder Modelländerung eine Meinungsfrage.
-
Szenariokatalog (Golden Set).
- Rund 120 Szenarien, als Einzelfragen und mehrstufige Dialoge, je mit Profil, Depot und eingefrorenen Marktdaten.
- Jedes Szenario trägt bis zu 26 prüfbare Erwartungen. Jede wird einzeln bewertet: erfüllt, teilweise oder verfehlt.
-
LLM-as-a-Judge mit fester Rubrik.
- Sechs Dimensionen: Profilpassung, sachliche Richtigkeit, Konsistenz, Prozessklarheit, Risikotransparenz, Beratungserlebnis.
- 16 vorgegebene Befundkategorien in vier Gruppen: Belegbarkeit, Inhalt, Prozess, Form.
- Die Kategorien sind per Schema erzwungen, damit Befunde über alle Läufe hinweg vergleichbar bleiben.
-
Deterministische Prüfregeln neben dem Judge (Grounding Checks).
- 34 Befundkategorien, unter anderem: erfundene Links, interne Bezeichner in der Antwort, Handelsaufforderung, stillschweigend übergangene Kandidaten.
- Zahlen werden mit den Werkzeugergebnissen abgeglichen.
- Jede Antwort wird gegen die vorgesehene Werkzeugkette geprüft: fehlender Schritt, falsche Reihenfolge.
- Neue Regeln werden vor dem Scharfschalten am Bestand gespeicherter Antworten auf Fehlalarme vermessen.
-
Gegendruck-Tests (Sycophancy). Der simulierte Nutzer widerspricht oder drängt. Geprüft wird, ob das System bei der Sache bleibt, statt gefällig nachzugeben.
Mehr Details
-
Klare Bestehensregel. Gesamtnote mindestens 4 von 5, keine Erlebnis-Dimension unter 3, kein schwerer Befund – weder vom Judge noch von einer Prüfregel.
-
Der Judge wird selbst geprüft (Judge-Kalibrierung).
- Mehrfachbewertung derselben Antworten, ein zweites Judge-Modell, verblindete Stichproben.
- Vergleich mit der Streuung zweier identischer Läufe. Erst was über diesem Rauschboden liegt, gilt als Veränderung.
Beratungsmehrwert
- Eval-Framework für Chatbots und AI Agents: Golden Set aus Fachanforderungen, Rubrik, Prüfregeln, Bestehensregel.
- Kalibrierung von LLM-as-a-Judge, damit Bewertungen belastbar und auditierbar sind.
- Chat Grading als Quality Gate im Release-Prozess.
Muster D: Prompt & Context Engineering: ein probabilistisches Modell bedient deterministische Werkzeuge
Tool Calling & Context Engineering
- Tool Calling
- Context Engineering
- Guardrails
- Human-in-the-Loop
- Prompt Caching
- Single Source of Truth
Herausforderung: Sprachmodelle formulieren überzeugend, rechnen aber unzuverlässig und kennen keine aktuellen Daten. Im Unternehmen müssen Zahlen stimmen, Abläufe einer Ordnung folgen und Schreibzugriffe kontrolliert sein.
-
Arbeitsteilung als Architekturprinzip (Tool Calling).
- Das Modell versteht die Frage, wählt Werkzeuge und erklärt die Ergebnisse.
- Rechnen, prüfen, filtern und buchen tun 55 Werkzeuge. Jede Zahl in einer Antwort stammt aus einem Werkzeugaufruf.
-
Werkzeugbeschreibungen sind Schnittstellenverträge (Single Source of Truth).
- Das Modell folgt im Zweifel der Beschreibung des Werkzeugs, nicht dem Systemprompt.
- Deshalb sind die Prozessketten einmal zentral als Daten hinterlegt, und ein Test verhindert, dass eine Werkzeugbeschreibung davon abweicht.
-
Quittungen statt Hoffnung. Werkzeuge melden zurück, was geprüft, was übersprungen und welcher Schritt noch offen ist. Das lenkt das Modell deterministisch zurück in den Prozess.
-
Selbstkorrektur in drei Stufen.
- Ungültige Eingaben werden abgelehnt.
- Abweichungen kommen als Warnung zurück.
- Wo ein objektives Soll-Ist prüfbar ist, rechnet ein stiller Probelauf vor der Ausführung.
Mehr Details
-
Freigabe im Code (Human-in-the-Loop).
- Schreibende Werkzeuge laufen erst nach dem Klick des Nutzers.
- Die Buchung muss exakt der gezeigten Vorschau entsprechen: serverseitig geprüft, einmalig, höchstens 30 Minuten gültig.
- Neue Depot-Aktionen sind standardmässig freigabepflichtig (Sperrliste statt Freigabeliste).
-
Schutz an der Ausgabe (Output Guardrails). Interne Bezeichner werden deterministisch herausgefiltert. Leere Antworten werden erkannt, aufgefangen und nicht verrechnet.
-
Context Engineering mit Cache-Ökonomie (Prompt Caching).
- Über 30 Prompt-Bausteine in vier Segmenten.
- Der unveränderliche Kern (rund 80'000 Tokens) wird eine Stunde lang für alle Nutzer gemeinsam gecacht, Workflow-Blöcke fünf Minuten. Der Nutzerkontext steht zuletzt.
- Gemessen: Ein kalter Cache-Aufbau kostet rund zehnmal so viel wie ein Cache-Treffer.
- Live-Daten stehen nie im Prompt.
-
Regeln mit Herkunft. Fachregeln im Prompt tragen ihren Evidenzstatus. Prompt-Versionen werden mitprotokolliert, damit Ergebnisse vergleichbar bleiben.
Beratungsmehrwert
- Architektur-Review für AI Agents: Grenze zwischen Modell und Werkzeug, Werkzeugverträge, Guardrails, Freigabepunkte.
- Context Engineering und Kostenoptimierung durch Segmentierung und Prompt Caching.
- Human-in-the-Loop-Design für schreibende KI-Aktionen.
Muster E: Strukturierte und unstrukturierte Daten interpretieren
Grounding & Structured Outputs
- Grounding
- Structured Outputs
- Agentic Retrieval
- Data Provenance
- Hallucination Rate
- Prompt-Injection-Abwehr
Herausforderung: Unternehmenswissen steckt in Tabellen und Kennzahlen ebenso wie in Berichten, Nachrichten und Freitext. Ein Sprachmodell soll beides nutzen, ohne Werte zu erfinden und ohne Fremdtext als Anweisung zu verstehen.
-
Grounding über Werkzeuge (Agentic Retrieval). Das Modell holt Daten bei Bedarf über Werkzeuge, statt aus seinem Trainingswissen zu antworten; jede Zahl ist auf einen Werkzeugaufruf rückführbar.
-
Strukturierte Daten.
- Eine Adapter-Schicht normalisiert Marktdaten, etwa Währungseinheiten, und macht den Anbieter per Konfiguration austauschbar (weniger Vendor Lock-in).
- Ein nächtlicher Bewertungslauf über ein Universum von rund 2'000 Titeln archiviert Kennzahlen zeitpunktgenau.
- Kennzahlen werden vor dem Vergleich auf eine Währungsbasis gebracht.
- Nicht bewertbare Positionen werden offengelegt, statt still mit Annahmen gerechnet zu werden.
-
Unstrukturiert wird strukturiert (Structured Outputs).
- Sprachmodelle lesen Nachrichtentexte, Geschäftsberichte und Webquellen und schreiben in feste Schemas.
- Beispiele: die Themenzuordnung jedes Titels mit Überzeugungsstufe, Marktkatalysatoren mit Konfidenz und Quelle (Data Provenance).
-
Geschlossenes Vokabular, gemessene Halluzination.
- Das Modell wählt aus vorgegebenen Kategorien. Nennt es eine, die es nicht gibt, wird sie verworfen und gezählt.
- Der Grund: Eine still steigende Halluzinationsquote ist der Fehler, der von aussen am gesündesten aussieht.
Mehr Details
-
Regeln, wo Regeln reichen.
- Die Stimmungsanalyse berücksichtigt Wortgrenzen, Verneinungen und die Sprache.
- Nachrichten werden am Artikeltext eingeordnet, nicht an der Schlagzeile.
-
Stabilität gemessen. Wiederholungsläufe zeigen, wie stark KI-Einschätzungen zwischen identischen Läufen schwanken. Dieser Rauschboden ist die Messlatte für jede angebliche Verbesserung.
-
Fremdtext ist Daten, nie Anweisung.
- Jeder Teil-Agent, der Fremdtext liest, folgt dieser Regel.
- Die Web-Recherche ist zusätzlich architektonisch isoliert: Sie erhält nur eine bereinigte Marktfrage, nie Nutzer- oder Depotdaten.
Beratungsmehrwert
- Intelligent Document Processing: Extraktion aus Dokumenten und Freitext mit Schema zuerst, Validierung, Herkunft und Konfidenz.
- Stabilität und Halluzinationsquote als Betriebskennzahlen.
- Abwehr von Prompt Injection über die Architektur, nicht nur über Prompt-Regeln.
Muster F: Responsible AI: Governance, Datenschutz und Sicherheit by Design
Responsible AI & Guardrails
- Privacy by Design
- Policy as Code
- Data Residency
- Zero Data Retention
- AI Security
- Supply Chain Security
Herausforderung: Richtlinien, die nur im Prompt oder im Handbuch stehen, sind Absichten. Belastbar werden sie, wenn Code sie erzwingt und Tests ihre Einhaltung prüfen.
-
Datenresidenz als Test.
- Jeder KI-Aufruf ist im Code auf die EU-Region, Zero Data Retention und den Ausschluss von Modelltraining festgelegt. Ein Test schlägt fehl, wenn ein neuer Aufruf das umgeht.
- Einzige offengelegte Ausnahme ist die abschaltbare Web-Recherche. Sie übermittelt nur eine bereinigte Marktfrage ohne Personen- oder Depotdaten.
- Diese Anfrage läuft direkt beim Modellanbieter in den USA, ebenfalls ohne Speicherung.
-
Datenschutz im Datenmodell.
- Kontonummern, Karten- und Steuernummern werden vor dem Speichern maskiert.
- Hochgeladene Bilder werden nach der Auswertung entfernt.
- Besonders schützenswerte Angaben werden nie ins Gedächtnis übernommen.
- Nutzer können Löschfristen für ihre Chats wählen.
-
Schutz vor Prompt Injection.
- Über den Chat: Freigaben, Berechtigungen und Ausgabefilter sind im Code erzwungen – kein Prompt kann sie aushebeln.
- Über Werkzeuge: Externe Inhalte wie Nachrichtentexte oder Webquellen sind Daten und gelten nie als Anweisung.
-
Berechtigungen serverseitig. Vom Modell gelieferte Kennungen werden gegen den Eigentümer geprüft. Auch nicht abgerechnete Lesepfade sind ratenbegrenzt.
Mehr Details
-
Lieferkette (Supply Chain Security). Abhängigkeiten werden automatisch aktualisiert. Neue Paketversionen werden erst nach einer Mindestwartezeit übernommen. Installationsskripte laufen nur nach expliziter Freigabe.
Beratungsmehrwert
- AI-Governance-Rahmen (Responsible AI): Datenresidenz, Datenschutz, Freigaben, Protokollierung – umgesetzt als Policy as Code.
- AI Security Review entlang der OWASP Top 10 für LLM-Anwendungen: Prompt Injection, Datenabfluss, Berechtigungen, Lieferkette.
Muster G: Evidenzbasierte Entscheidungen und Kostensteuerung
Evidence-based AI & LLM-FinOps
- Model Benchmarking
- A/B-Testing
- Unit Economics
- LLM-FinOps
- Observability
Herausforderung: Bei Modellwechseln, neuen Prompts und neuen Funktionen entscheidet ohne Messung das lauteste Argument. Und ohne Kostentransparenz skaliert ein KI-System in die falsche Richtung.
-
Modellwahl per Experiment (Model Benchmarking).
- Ein grösseres Sprachmodell trat gegen das eingesetzte an.
- Aufbau: 38 Szenarien mit 81 Dialogschritten, zwei Läufe je Variante, zwei verschiedene Bewertungsmodelle.
- Ergebnis Qualität: Der Unterschied lag in drei von vier Vergleichen innerhalb der Streuung zweier identischer Läufe, in einem knapp darüber, und war nirgends signifikant.
- Ergebnis Kosten und Zeit: rund 2,2-fache Kosten je Dialogschritt, Median-Antwortzeit rund 30 Sekunden länger.
- Entscheidung: kein Wechsel.
-
Statistik statt Bauchgefühl. Gepaarte Vergleiche mit exakten p-Werten, Korrektur für Mehrfachtests (Benjamini-Hochberg), vorab registrierte Vergleichspaare.
-
Forschung vor Funktion.
- Über 200 Auswertungs- und Forschungsskripte, darunter 23 Studien zur Vorhersagekraft einzelner Signale.
- Hypothesen, die nicht standhalten, kommen nicht ins Produkt.
-
Kosten im Griff (Unit Economics).
- Der Verbrauch wird je Nutzer und Monat gemessen und begrenzt.
- Hintergrundarbeit wie Gedächtnis und Recherche wird in eigenen Töpfen ausgewiesen.
- Prompt-Caching und das Lesen aus der Datenbank statt Live-Abrufen senken die Kosten je Dialogschritt.
Beratungsmehrwert
- Model Selection und Benchmarking auf Basis eigener Messungen statt Herstellerangaben.
- Experimentdesign für KI-Funktionen: Kontrollgruppe, Rauschboden, Mehrfachtest-Korrektur.
- LLM-FinOps: Kostenmodell (Unit Economics, TCO), Budgets, Caching-Strategie.
Von der Programmdisziplin zur KI-Disziplin
Dieselben Disziplinen, die eine SAP-Transformation tragen, entscheiden auch darüber, ob ein KI-Vorhaben vom Pilot in den Betrieb kommt (Pilot-to-Production). Das Projekt übersetzt sie in ein Operating Model für KI-Systeme:
| Disziplin in Enterprise-Programmen | Entsprechung bei KI-Systemen | Umsetzung im Projekt |
|---|---|---|
| Abnahmekriterien | Entsprechung bei KI-Systemen Bewertungsrubrik und Bestehensregel | Umsetzung im Projekt 6 Dimensionen, 16 Befundkategorien, Mindestnote 4 von 5 |
| Regressionstest vor dem Release | Entsprechung bei KI-Systemen Szenariokatalog mit echtem Modell | Umsetzung im Projekt rund 120 Szenarien mit eingefrorenen Marktdaten |
| Change- und Release-Management | Entsprechung bei KI-Systemen Pull Request mit automatischen Checks | Umsetzung im Projekt über 150 Pull Requests; automatische Checks auf jedem neuen Pull Request |
| Rollen und Freigaben | Entsprechung bei KI-Systemen Mensch im Prozess bei Schreibzugriffen | Umsetzung im Projekt Freigabe-Klick und Vorschau-Abgleich |
| Cutover und Go-Live-Steuerung | Entsprechung bei KI-Systemen Gestufte, sichere Migration | Umsetzung im Projekt Migrationen zuerst in Agenten- und Vorschau-Umgebungen, erst danach in der Produktion |
| Wissensmanagement | Entsprechung bei KI-Systemen Versionierte Wissensbasis für Agenten | Umsetzung im Projekt 38 Wissensdateien im Repository |
| Compliance und interne Kontrollen | Entsprechung bei KI-Systemen Richtlinien als automatisierte Tests | Umsetzung im Projekt EU-Bindung, Job-Überwachung, Sprachkatalog |
| Business Case | Entsprechung bei KI-Systemen Kosten je Vorgang, Entscheid per A/B-Messung | Umsetzung im Projekt Modellwechsel verworfen: 2,2-fache Kosten ohne messbaren Mehrwert |
| Hypercare und Betrieb | Entsprechung bei KI-Systemen Überwachung und Rückkopplung | Umsetzung im Projekt jeder Job überwacht, reale Fehlgriffe werden Testfälle |
Das Projekt in Zahlen
Laufend im Ausbau
- gemergte Pull Requests, 146 davon von KI-Coding-Agenten
- 155
- Commits
- 1'758
- automatisierte Testfälle
- > 2'300
- bewertete Dialog-Szenarien
- 121
- Kategorien deterministischer Prüfregeln
- 34
- Werkzeuge
- 55
- Titel im Bewertungsuniversum
- ~2'000
- zeitgesteuerte Jobs, alle überwacht
- 26
- Zeilen TypeScript, davon rund 120k Auswertungs- und Forschungsrahmen
- ~360k
- Wissensdateien für KI-Agenten
- 38
- Datenbanktabellen
- 64
- Seiten- und API-Routen
- 96
- Sprachfassungen mit je rund 5'900 Texten
- 2
- Abrechnungswährungen
- 3
Architektur in fünf Schichten
Die Analysebasis entsteht vorgelagert und deterministisch. Der KI-Anteil interpretiert – er bewertet nicht selbst.
Oberfläche
Depot, Watchlist und Dialog in einer Ansicht. Mehrsprachig, hell und dunkel, mobil nutzbar.
- Next.js
- React
- Tailwind CSS
Assistenz-Schicht
Fachliche Leitplanken, Gesprächsführung mit Bestätigungspunkten und 55 Werkzeuge, die der Assistent aufrufen darf.
- Tool Calling
- Human-in-the-Loop
- Quittungen
Analyse-Engine
Ein nächtlich berechnetes Multi-Faktor-Ranking bewertet das gesamte Universum, zeitpunktgenau archiviert und damit reproduzierbar.
- deterministisch
- Point-in-Time-Archiv
Daten & Aufträge
Depot, Transaktionen, Profil und Verbrauch in einer relationalen Datenbank; 26 zeitgesteuerte Jobs halten Kurse, Themen und Kennzahlen aktuell.
- PostgreSQL
- Cron
- Cache & Sperren
- Adapter-Schicht für Marktdaten
Betrieb & Governance
Anmeldung mit Passwort und Passkey, Abrechnung in drei Währungen, Verbrauchsmessung, Fehlerdiagnose, Ratenbegrenzung, Überwachung jedes Jobs.
- EU-Region (Ausnahme: Web-Recherche)
- ohne Speicherung der KI-Anfragen
Ablauf einer Analyse
Kein Vorschlag ohne Profilabgleich, keine Depotänderung ohne Freigabe – das ist die Abgrenzung zum allgemeinen KI-Chatbot.
- AnlageprofilZiel, Horizont, Risikoneigung und Risikofähigkeit, erlaubte Vehikel, Heimatmarkt, Währung
- BestandsaufnahmeDepot, Klumpenrisiken, Sektor-, Regionen- und Währungsverteilung
- ZielallokationHaltepunkt 1 – Strategie wird zur Freigabe vorgelegt
- Auswahl & PrüfungScreening, Ranking, Technik- und Fundamentalprüfung je Titel
- TitelvorschlagHaltepunkt 2 – Auswahl mit Begründung und Gegenargumenten
- UmsetzungErst nach Freigabe-Klick wird ins Depot geschrieben – exakt wie in der Vorschau gezeigt, ohne Broker, ohne Order
Verantwortungsbereiche
Ein Produkt, eine Verantwortung – von der Produktdefinition bis zum Betrieb.
Produkt & Positionierung
Zielgruppen, Nutzenversprechen, Funktionsumfang, Preismodell und Abgrenzung zu allgemeinen KI-Assistenten und Robo-Advisorn.
Lösungsarchitektur
Schnitt zwischen deterministischer Bewertung und KI-Interpretation, Datenmodell, Schnittstellen, Caching und Lastverhalten.
Umsetzung
Anwendung, Analyse-Engine, zeitgesteuerte Verarbeitung, Abrechnung, Benachrichtigungen und Oberfläche in zwei Sprachen – umgesetzt mit KI-Coding-Agenten.
Agentic Software Delivery
Entwicklungsprozess mit KI-Coding-Agenten: Rollen, automatische Checks, versionierte Wissensbasis, Rechtekonzept für Agenten.
Rechtliches
AGB, Datenschutzerklärung und Impressum.
Qualitätssicherung
Mehrstufige Testautomatisierung, LLM-Evals mit kalibriertem LLM-as-a-Judge und deterministischen Prüfregeln, Rückspiegelung realer Fehlgriffe als Testfall.
Betrieb & Kosten
Überwachung, Fehlerdiagnose, Ratenbegrenzung, Verbrauchsmessung je Nutzer und Abgleich der Modellkosten gegen den Kontostand.
Technologie
Bewusst schmaler, gut belegter Stack – jede Komponente ersetzbar, keine exotischen Abhängigkeiten.
- Anwendung
- Next.js (App Router), React, TypeScript
- Oberfläche
- Tailwind CSS, Komponentenbibliothek, hell/dunkel, mehrsprachig
- KI
- Anthropic-Modelle über AWS Bedrock in der EU-Region (Ausnahme: Web-Recherche), vermittelt über ein Gateway; Structured Outputs für alle Extraktionen, Prompt Caching
- Daten
- PostgreSQL mit typsicherem ORM und versionierten Migrationen; eigene Adapter-Schicht für Marktdaten, Anbieter austauschbar
- Entwicklung
- KI-Coding-Agenten (GitHub Copilot) in Entwicklungsumgebung und Cloud, Fehlerüberwachung per MCP angebunden; Pull-Request-Workflow mit automatischen Checks
- Anmeldung
- Passwort und Passkeys (WebAuthn)
- Abrechnung
- Stripe – Abonnements und Guthabenpakete in CHF, EUR, USD
- Betrieb
- Vercel, Redis für Begrenzungen und Sperren, E-Mail-Versand; Observability: Fehlerdiagnose auf EU-Instanz, Überwachung jedes zeitgesteuerten Jobs
- Qualität
- Unit-Tests, Playwright-End-to-End-Tests mit Mock-LLM, LLM-Evals (LLM-as-a-Judge und deterministische Prüfregeln), gepaarte A/B-Experimente
Freigaben und Datenschutz
Klare Regeln dafür, wann ins Depot geschrieben wird und wie mit Daten umgegangen wird.
- Freigabe vor jedem Schreibzugriff – Änderungen am Depot erst nach Klick des Nutzers, exakt wie in der Vorschau gezeigt.
- Datenverarbeitung in der EU – KI-Aufrufe sind per Code auf eine EU-Cloud-Region festgelegt, ohne Speicherung und ohne Modelltraining. Einzige offengelegte Ausnahme ist die abschaltbare Web-Recherche: Sie übermittelt nur eine bereinigte Marktfrage ohne Personen- oder Depotdaten und läuft direkt beim Modellanbieter in den USA, ebenfalls ohne Speicherung. Fehlerdiagnose auf einer EU-Instanz, Reichweitenmessung cookielos und ohne Profilbildung. Die Datenschutzerklärung benennt jeden eingesetzten Dienst einzeln.
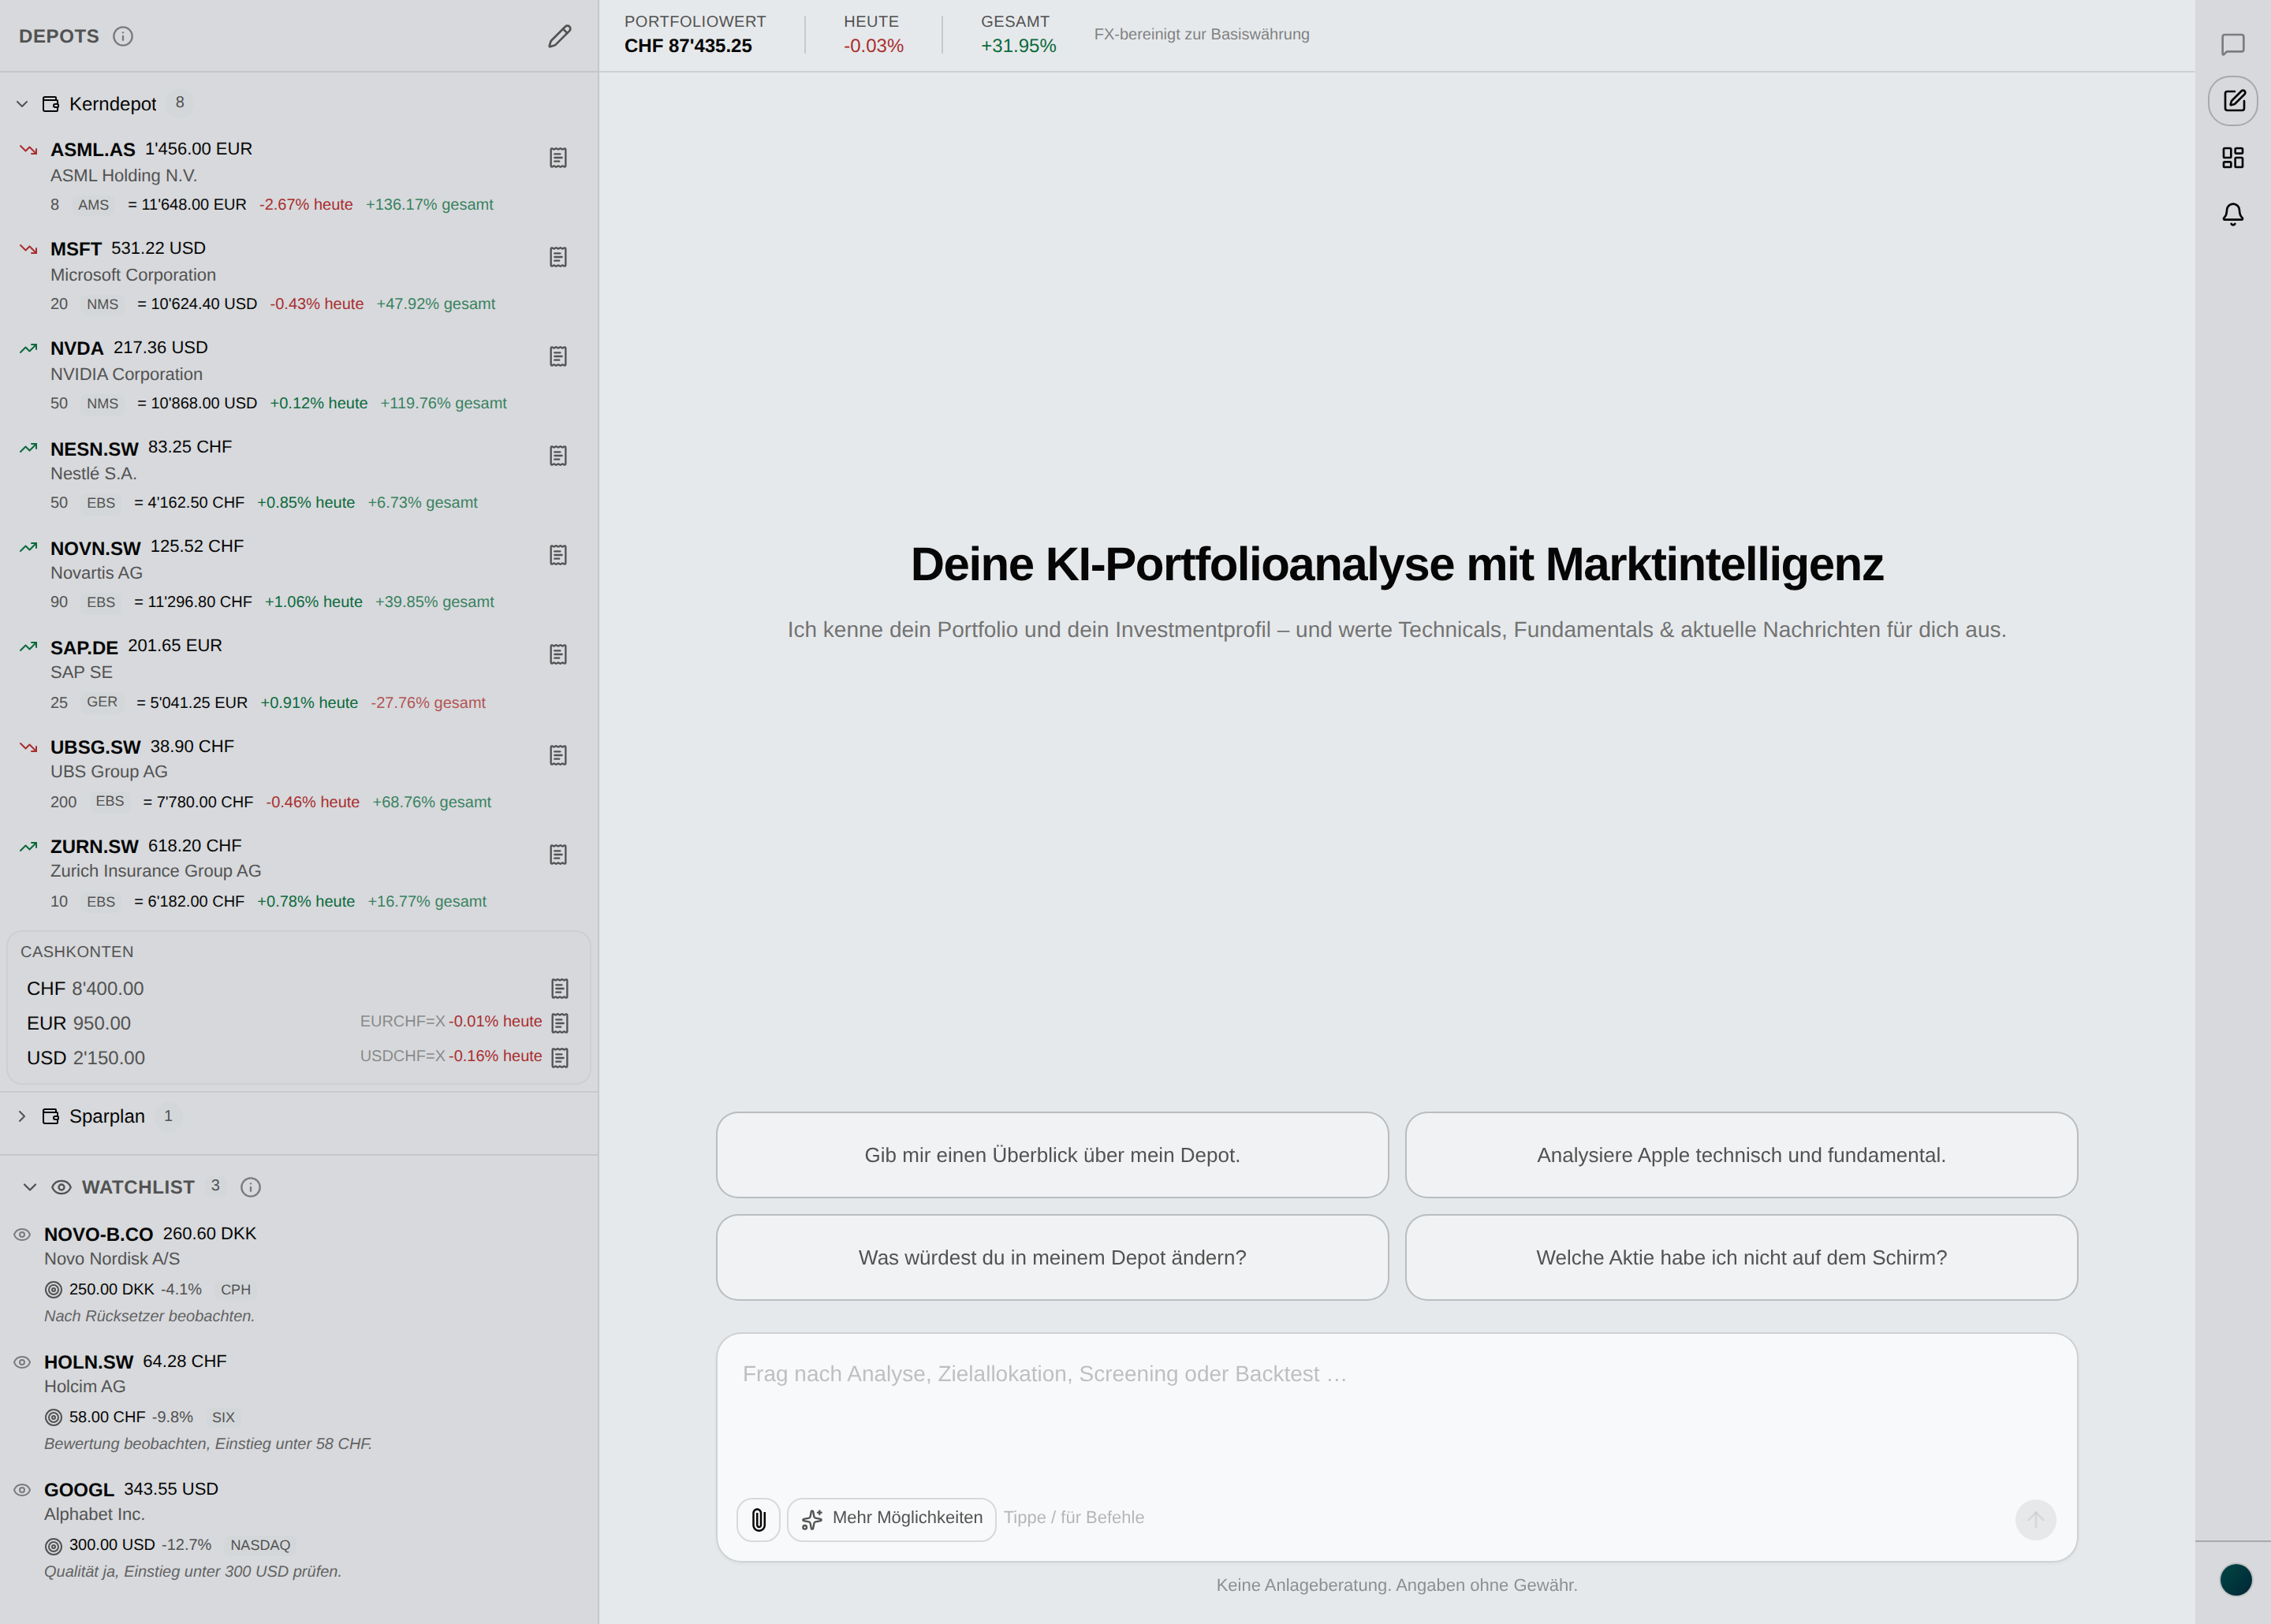
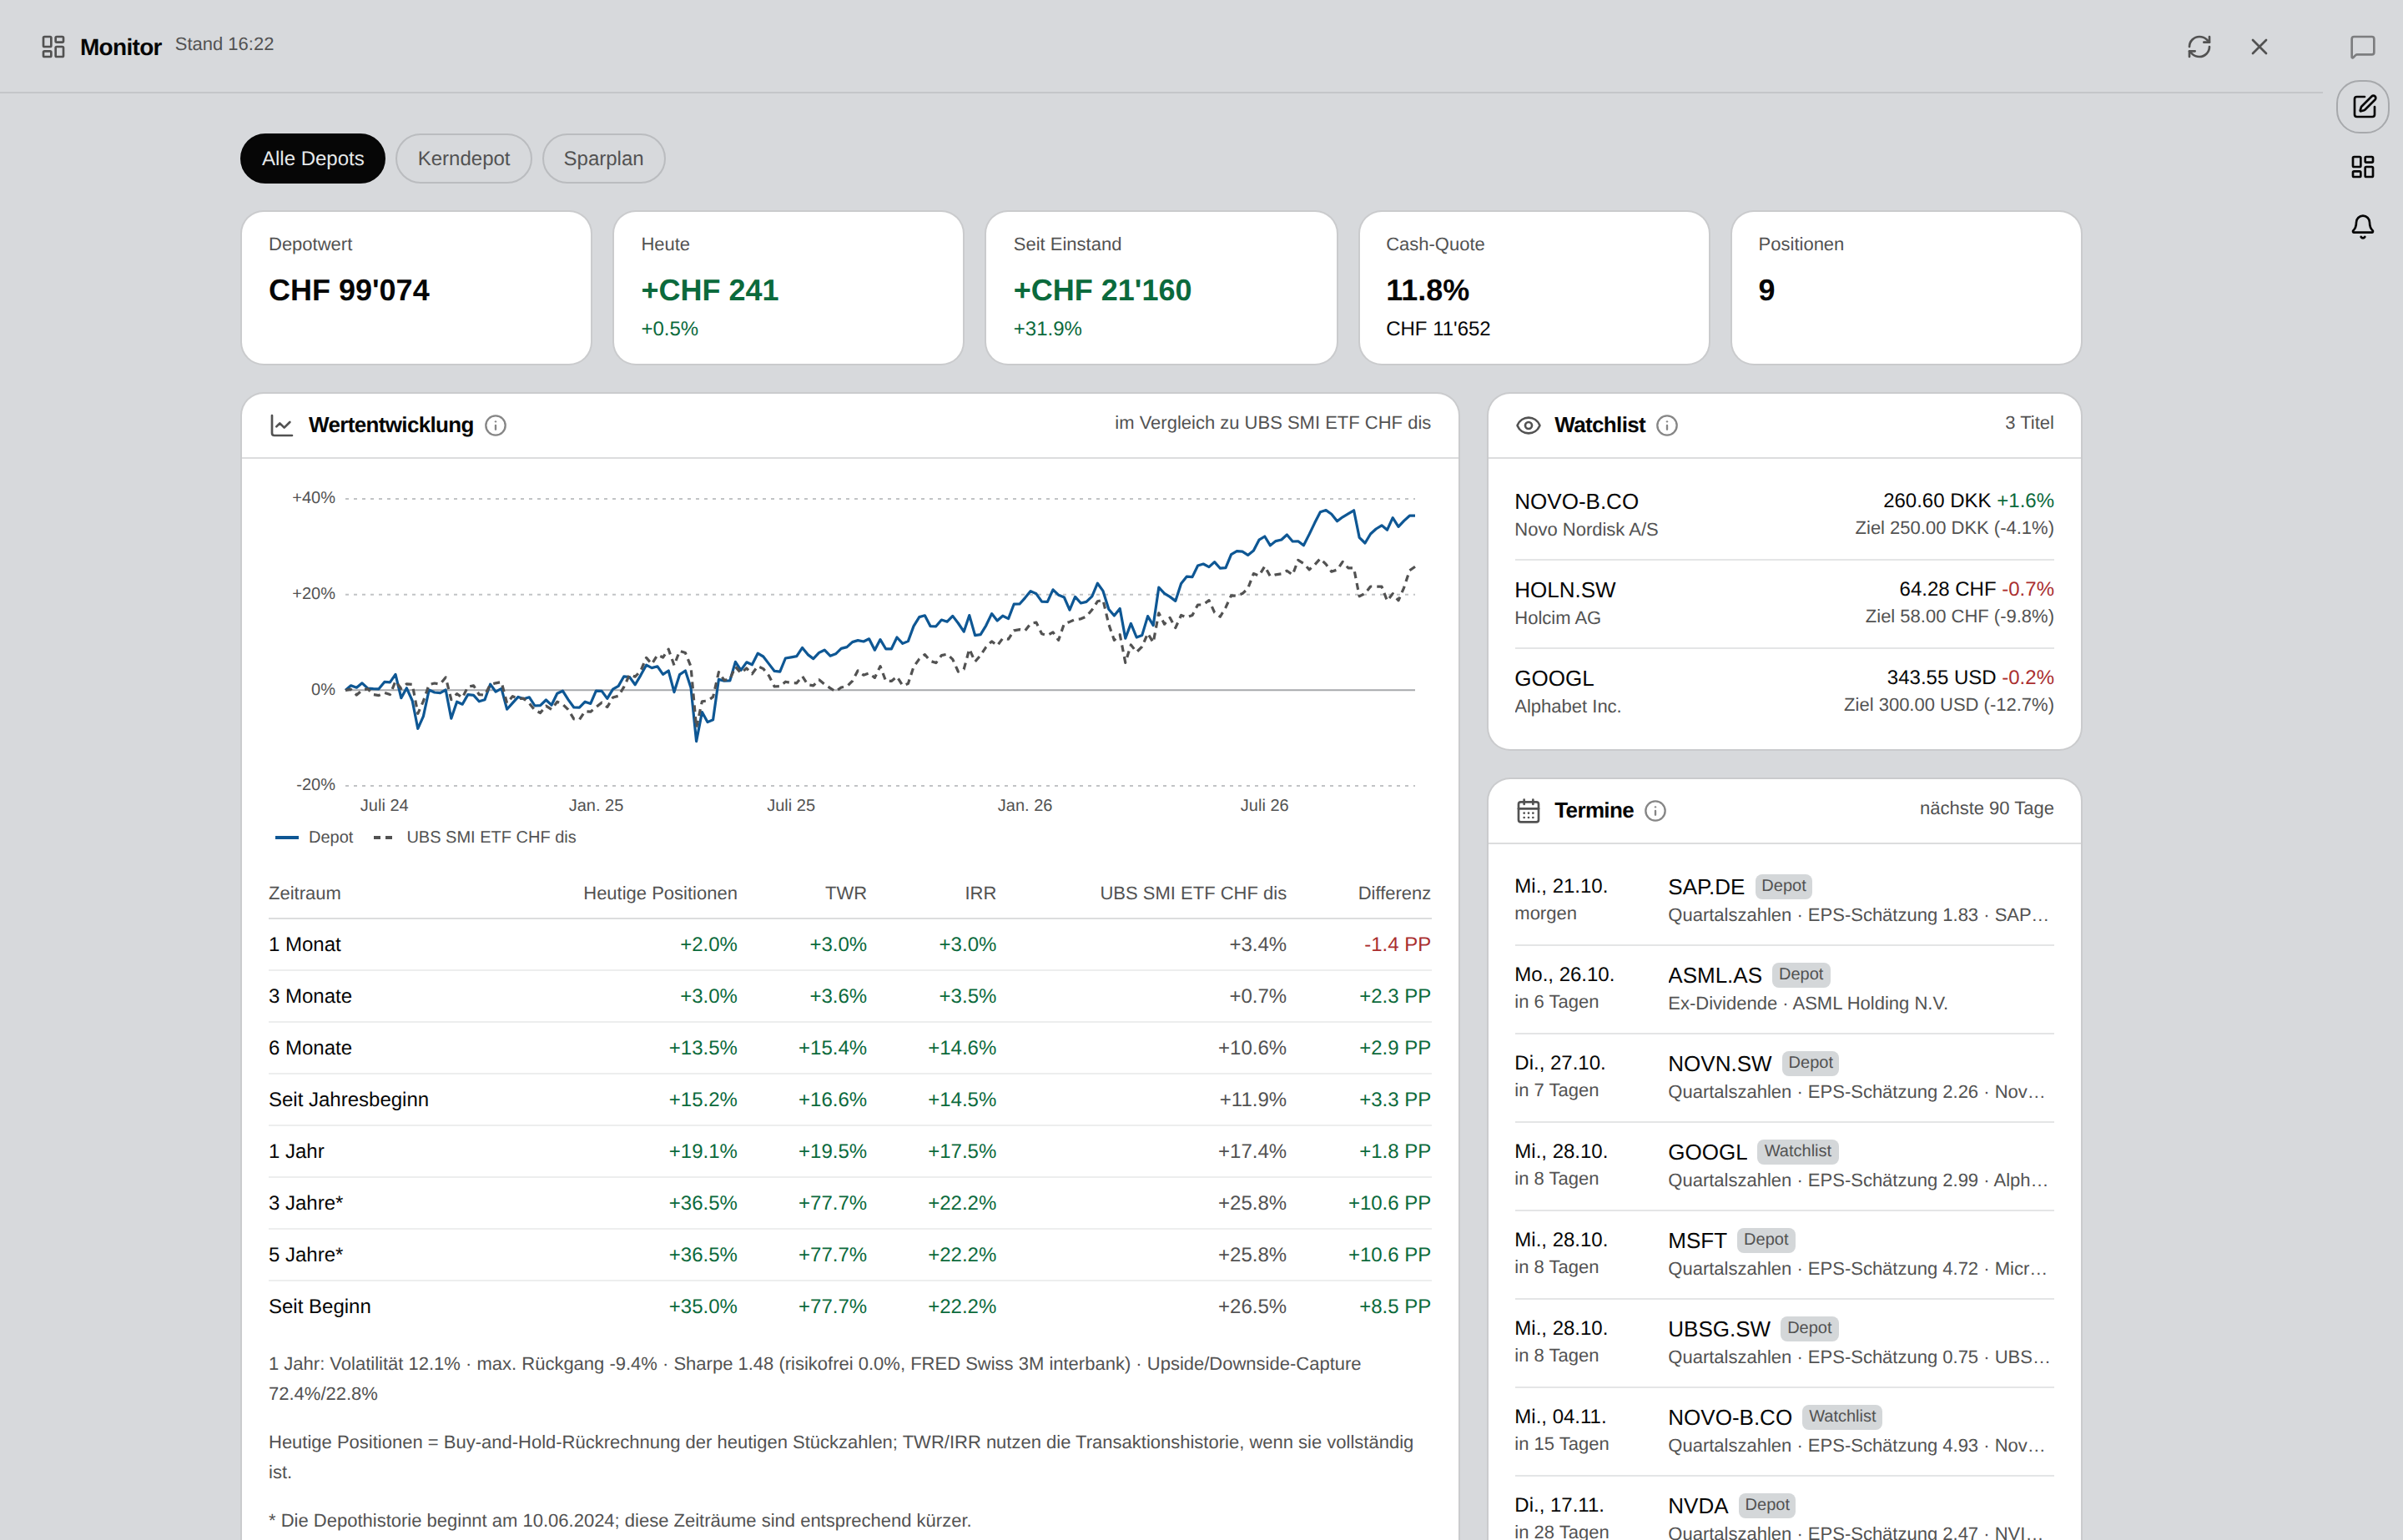
Einblicke in die Anwendung
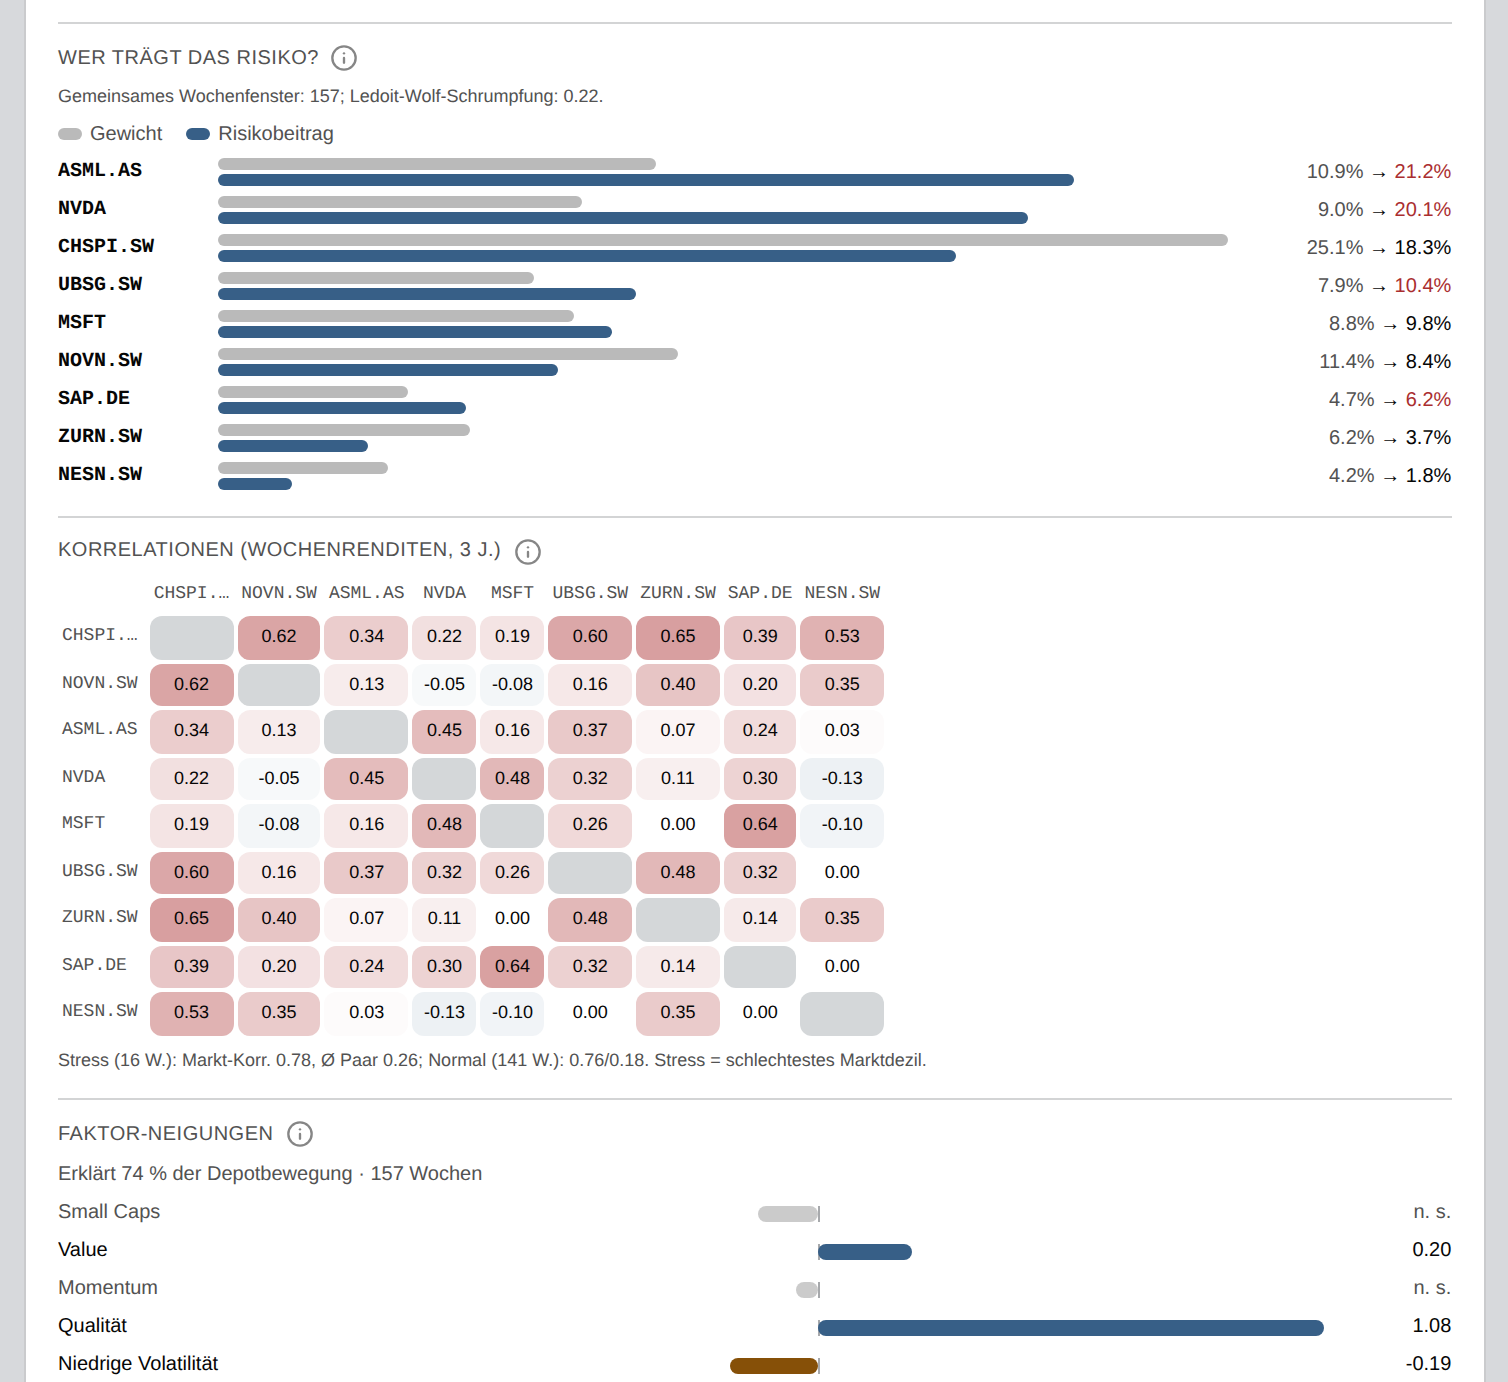
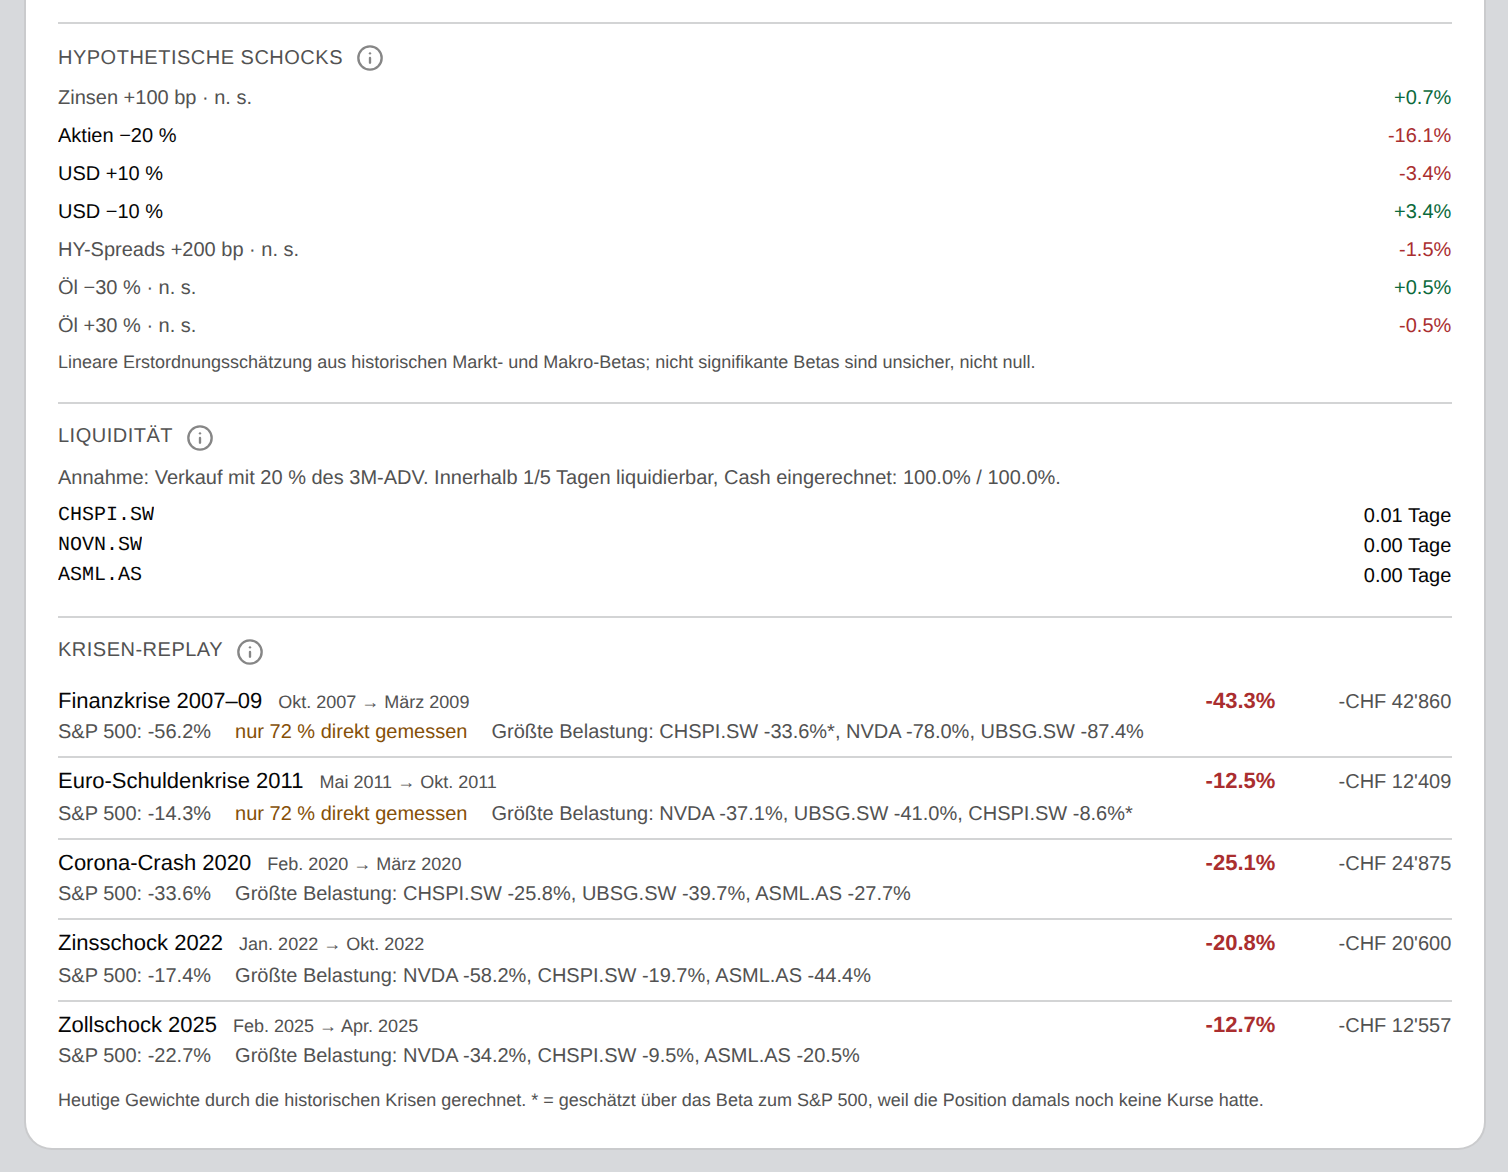
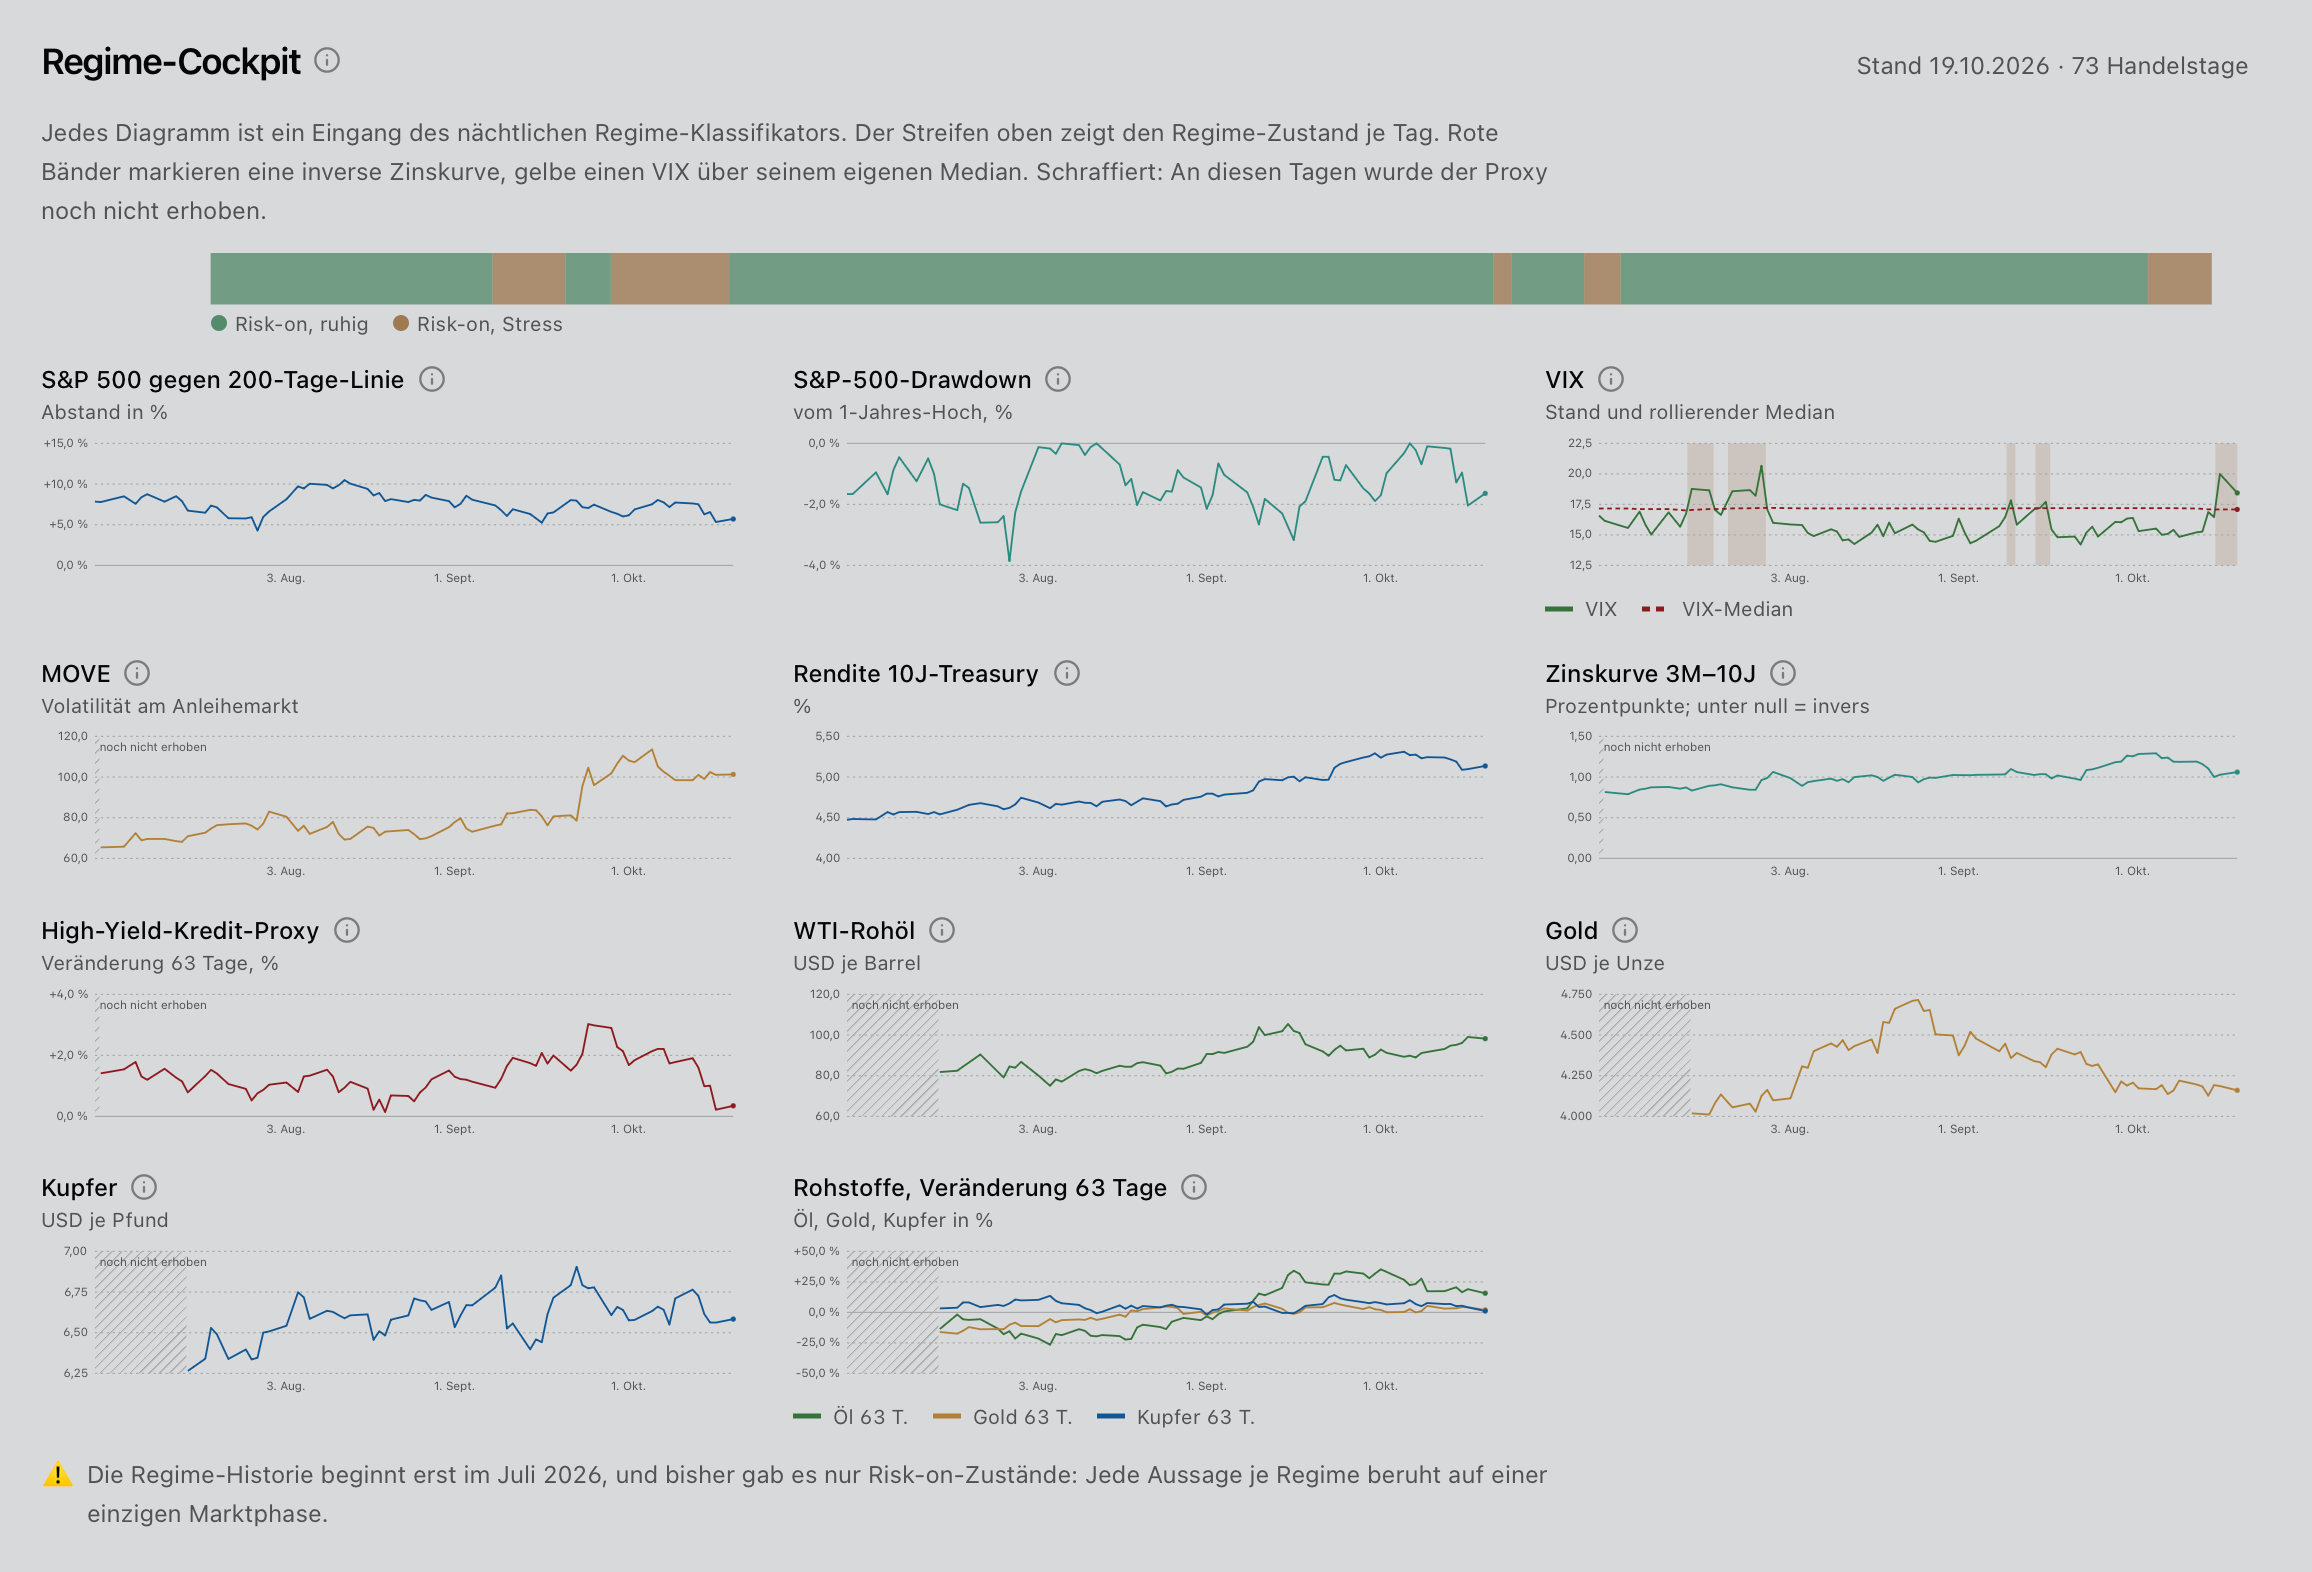
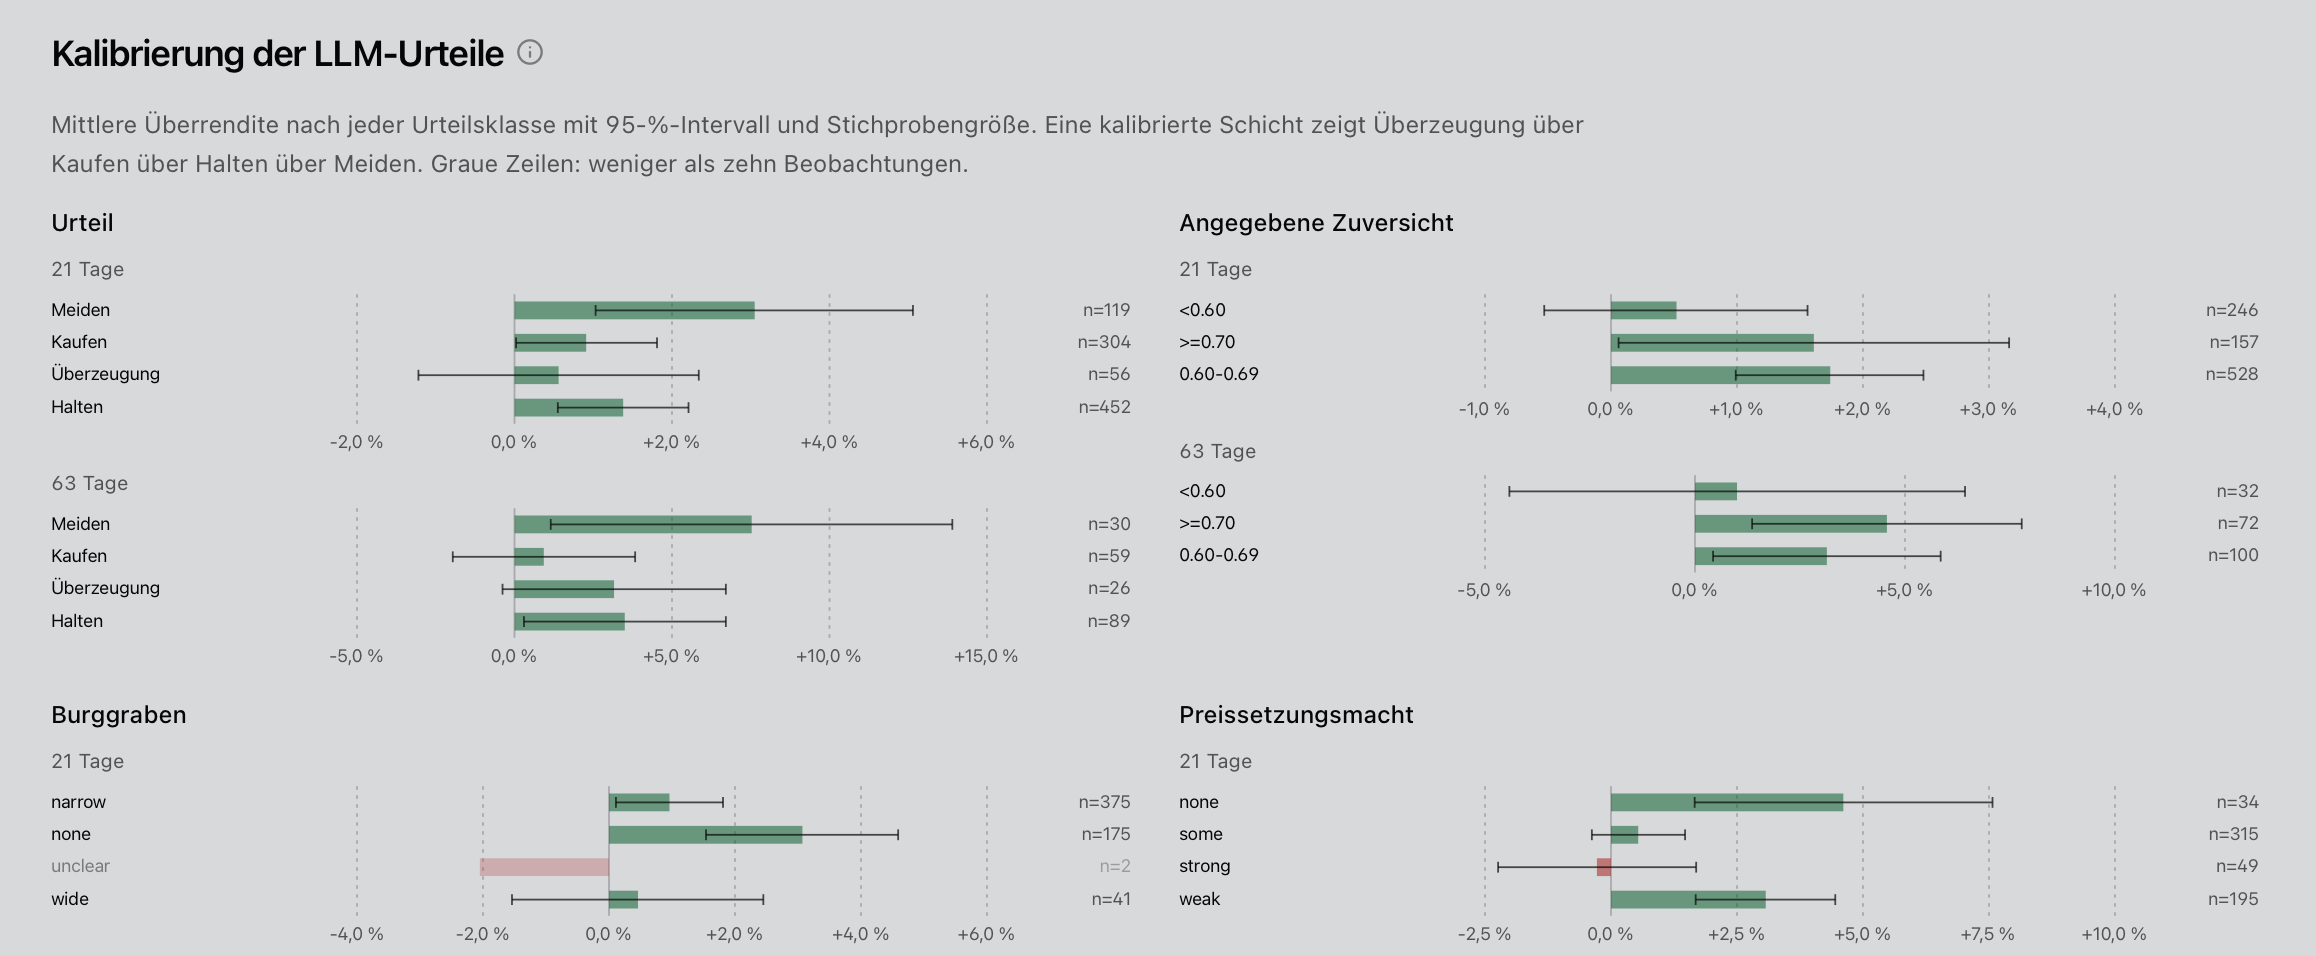
Depotführung mit KI-Assistent, Risikoanalyse und Stresstests im Depot-Monitor sowie zwei Kontrollansichten aus dem Admin-Bereich.
Vom AI-Pilot zum produktiven Betrieb
Die im Referenzprojekt hentschel.ai praktisch erprobten Methoden übertrage ich auf Enterprise-AI-Vorhaben – von AI-native Softwareentwicklung und Evaluation bis zu Architektur, Governance und Pilot-to-Production – als Transformation Lead, Projektleiter oder technischer Sparringspartner.
-
Agentic Delivery & AI-native SDLC
KI-Coding-Agenten in Ihre Entwicklung einführen – als Operating Model, nicht als Tool-Rollout
Ergebnisse
- AI-Readiness-Check
- Rollen- und Freigabemodell
- Pflicht-Checks
- Wissensbasis
- Rechtekonzept
-
LLM Evals & Chat Grading
Eval-Framework für Ihre Chatbots und AI Agents
Ergebnisse
- Golden Set aus Fachszenarien
- Rubrik
- Prüfregeln
- Quality Gate im Release
-
Agent & Context Architecture
Tool Calling, Guardrails und Human-in-the-Loop sauber schneiden
Ergebnisse
- Architektur-Review
- Werkzeugverträge
- Freigabepunkte
- Caching-Konzept
-
Intelligent Document Processing
Berichte und Freitext in prüfbare Strukturen überführen
Ergebnisse
- Schema-Design (Structured Outputs)
- Validierung
- Provenienz
- Stabilitäts- und Halluzinationsmessung
-
Responsible AI & AI Security
Richtlinien durchsetzen statt beschreiben
Ergebnisse
- Governance-Rahmen
- Policy-as-Code-Tests
- Security Review nach OWASP Top 10 für LLM-Anwendungen
-
AI Program Management
Vom Proof of Concept in den Betrieb (Pilot-to-Production)
Ergebnisse
- Roadmap
- Business Case mit Unit Economics
- Experimentdesign
- Projektleitung
Rainer Hentschel
Transformation Lead for the Autonomous Enterprise · SAP® Solutions & Agentic AI
Seit 17 Jahren führe ich komplexe internationale Technologie- und Transformationsvorhaben zum Erfolg. Ich verbinde Business und IT, strukturiere kritische Programme und bringe sie sicher in den Betrieb.
Auf dem Weg zum Autonomous Enterprise steht Unternehmen mit Agentic AI der nächste Paradigmenwechsel bevor: Aus Software as a Service wird zunehmend Service as a Software. KI-Agenten übernehmen Aufgaben in Entwicklung, Projektarbeit und Geschäftsprozessen. Teams verändern sich, Innovations- und Entwicklungszyklen werden kürzer.
Für diese Transformation verbinde ich 17 Jahre Delivery-Erfahrung aus internationalen Enterprise-Transformationen mit praktischer Agentic-AI-Engineering-Kompetenz – von Strategie und Architektur bis zur produktiven Umsetzung.